De la rédaction des polices à la détection des fraudes: la portée de la GenAI
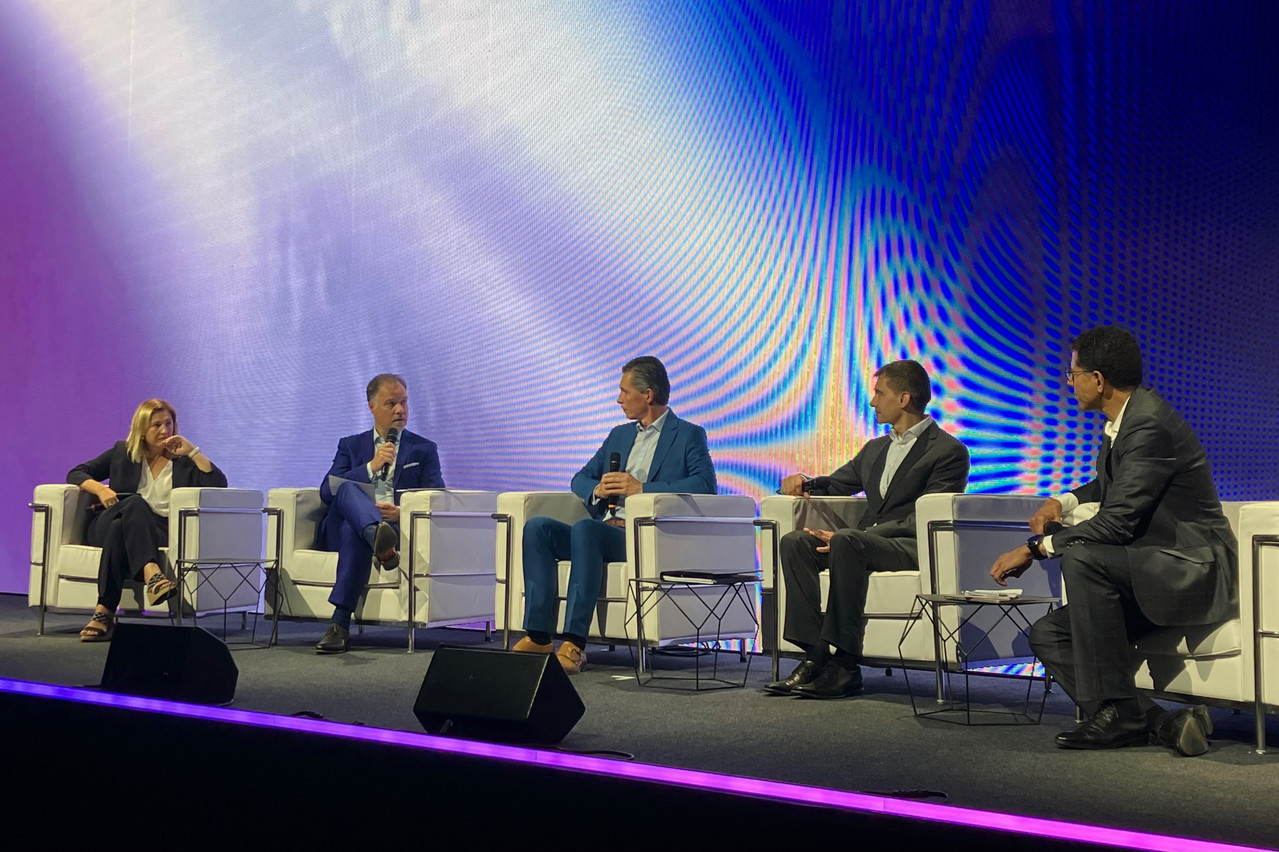
«La GenAI est le troisième aspect de l’IA, après l’IA symbolique et l’IA stochastique», a déclaré Habib Guergachi, architecte de logiciels de systèmes avancés et membre du conseil d’administration du Groupe Foyer. Elle se concentre sur l’intelligence du texte et du document et est capable de comprendre, de créer et d’inventer «comme un humain».
Dans le secteur de l’assurance, la GenAI offre des avantages en analysant les réglementations afin de fournir des conseils juridiques ou des formulations appropriées. Cela peut s’appliquer, par exemple, aux assurés transfrontaliers, a expliqué Nicolas Limbourg, président de l’Aca et directeur général de Vitis Life. Il a également souligné que les clients utilisent l’IA prédictive «pour attaquer les compagnies d’assurance en utilisant les faiblesses de la réglementation».
Reno Daigle, CIO & head of business transformation chez CNA/Hardy a commenté que la GenAI aide à l’analyse prédictive, en utilisant la jurisprudence pour aider à rédiger des contrats. En outre, les assureurs utilisent la GenAI pour identifier le libellé des polices, rechercher de la documentation pour les souscripteurs, détecter les fraudes en matière de sinistres et analyser une grande quantité de données en vue d’établir des probabilités.
Cependant, M. Daigle a fait remarquer qu’il existe des risques importants liés à la répétabilité (la même requête peut produire des réponses incohérentes) et à l’absence actuelle de traçabilité de la formulation des décisions, ce qui nécessite un examen et une prise de décision par des humains. Il a fait remarquer que si les clients pouvaient utiliser l’IA pour exploiter les faiblesses de la réglementation, les assureurs pouvaient également l’utiliser pour identifier et améliorer leur propre documentation.
Pour un secteur réglementé, «les résultats de l’IA doivent être traçables, vérifiables et explicables au client», a fait valoir Adina Grigoriu, CEO d’Active Asset Allocation.
Redesign pour une automatisation efficace
L’automatisation autonome efficace ne se limite pas à l’ajout de technologies; Elle exige une refonte des processus et des modèles d’entreprise fondamentaux. L’utilisation de technologies d’IA (symboliques, stochastiques ou génératives) sur des systèmes existants sera peu efficace, selon M. Guergachi.
D’après son expérience dans le cadre d’un projet en France, Mme Grigoriu pense qu’une approche réussie implique la co-construction d’infrastructures partagées qui utilisent des données conservées pour automatiser des tâches complexes, comme les parcours d’investissement individuels, tout en intégrant la conformité et l’efficacité opérationnelle. «Cela permet aux humains de se concentrer sur les activités à forte valeur ajoutée.»
C’est comme avoir un GPS sur lequel vous auriez installé la mauvaise carte. Il vous permettra d’arriver rapidement à destination, mais ce ne sera pas le bon endroit.
Elle a reconnu que pour le Luxembourg, la personnalisation à grande échelle dans de multiples juridictions et langues ajoute à la complexité, soulignant la nécessité d’une refonte solide du modèle d’exploitation, en faisant éventuellement le lien entre les systèmes existants et la programmation de l’interface de programmation des applications (API) pour accéder aux données.
Partenariat humain-AI dans les données d’assurance
Un défi majeur pour les assureurs est de gérer «d’énormes quantités de données héritées, souvent entachées de problèmes de qualité», observe M. Daigle. Si l’IA peut aider à analyser les problèmes de qualité des données, elle ne les résoudra pas complètement. Nicolas Limbourg a noté qu’une collaboration avec les intermédiaires et les insurtechs est cruciale pour améliorer la qualité des données, d’autant plus que de nombreux assureurs ont peu de contacts directs avec les clients.
Une étape fondamentale consiste à «refondre le dictionnaire du système d’information», a déclaré M. Guergachi. Cela signifie qu’il faut définir méticuleusement chaque mot et chaque concept, en impliquant toutes les parties prenantes des différents départements (finances, réclamations, informatique). Cette refonte doit se faire de l’extérieur vers l’intérieur, en commençant par l’expérience de l’utilisateur et du client. La deuxième phase, celle de l’automatisation, ne peut être menée à bien «sans un dictionnaire, sans une ontologie». Mme Grigoriu a ajouté que «c’est comme avoir un GPS sur lequel on adapte la mauvaise carte. Il vous mènera rapidement à destination, mais ce ne sera pas le bon endroit.»
«Deepseek a créé un ensemble de données très propres à l’aide de la distillation. Il a transformé les mauvaises données en bonnes données en utilisant ChatGPT sur Cloudthree. C’est pourquoi ils ont réussi à créer un modèle très efficace», a déclaré M. Guergachi. M. Limbourg pense que le rôle des employés reste essentiel pour interpréter les résultats de l’IA, en garantissant la cohérence, la pertinence et l’adaptation à des contextes spécifiques.
Le meilleur assureur de la prochaine décennie en un mot?
Mme Grigoriu: «Adaptatif.»
M. Limbourg: «Une société de services axée sur les données et l’expérience client, capable de fournir des solutions complètes et personnalisées.»
M. Daigle: «Flexible.»
M. Guergachi: «Un produit pour une revendication.»
Instructions finales
Le principal obstacle à l’innovation dans le secteur de l’assurance est la peur de rompre avec ce qui fonctionne actuellement, même si c’est inefficace, et la résistance aux changements importants dans la technologie et les modèles opérationnels.
L’indicateur clé de performance (ICP) de l’innovation est l’adoption, a conclu M. Grigoriu. Ce qui effraie le plus les panélistes, ce sont les mauvaises données dans de très bons systèmes, car elles conduisent à des résultats confiants mais incorrects et, en fin de compte, à l’absence totale d’innovation.
Cet article a été rédigé initialement en anglais et traduit et édité en français.